LLM(大規模言語モデル、Large Language Model)を教師とした知識蒸留(Knowledge Distillation)により、人材領域に特化した軽量・高速なBERT埋め込みモデルを構築した取り組みを紹介します。本成果は言語処理学会第32回年次大会(以下、NLP2026)にてポスター発表(C7-6)として発表しました。
はじめに
はじめまして。ビズリーチのAIプロダクトグループの原龍昊です。
ビズリーチでは、求人票や職務経歴書(レジュメ)などの大量のテキストデータが日々蓄積されています。AIプロダクトグループのミッションの一つは、これらのデータを活用して企業と求職者の最適なマッチング機会を創出することです。
これらのテキストデータを処理する上で、以下の3つの要件が求められます。
- 高精度: 業界特有の専門用語を多く含む長文の意味的類似度を正確に捉える
- 高速性: 大量の文書をリアルタイムに処理できる
- セキュリティ: 機密性の高い社内データを外部に送信しない
AIプロダクトグループでは、これらの要件を満たすため、LLMを活用した知識蒸留によってドメイン特化の軽量BERTモデルを構築し、OpenAI Embedding APIと同等以上の性能を示すことを確認しました。本記事では、手法と実験結果の概要、NLP2026で発表した様子をご紹介します。
背景と課題
既存技術の限界
テキスト間の意味的類似度計算には、これまで統計的手法(TF-IDF、LDA(Latent Dirichlet Allocation)など)や汎用OSS BERTモデル(ruri、GLuCoSEなど)が利用されてきました。 しかし、統計的手法では文脈を十分に捉えられず、汎用OSS BERTモデルは人材業界特有の専門用語への対応が不十分です。例えば、「エンジニアリングマネージャー」「法人営業」といったHR領域の複合語を、意味を損なわずに処理することが難しく、結果的に類似度の精度が低下します。
LLMは高精度なテキスト理解を実現しますが、大量の文書を処理する際には推論コストが高く、応答速度の低下が避けられません。外部APIを利用する場合は、社内の機密データを送信するセキュリティリスクも生じます。
解決策:LLM知識蒸留によるドメイン特化モデル
そこで私たちは、「LLMを教師(Teacher)とした知識蒸留」というアプローチを採用しました。LLMが持つ高精度な言語理解能力を、軽量なBERTモデルへ転移させることで、精度・速度・セキュリティを同時に実現することを目指しました。
提案手法の全体像
提案手法は以下の3つのステップで構成されます。
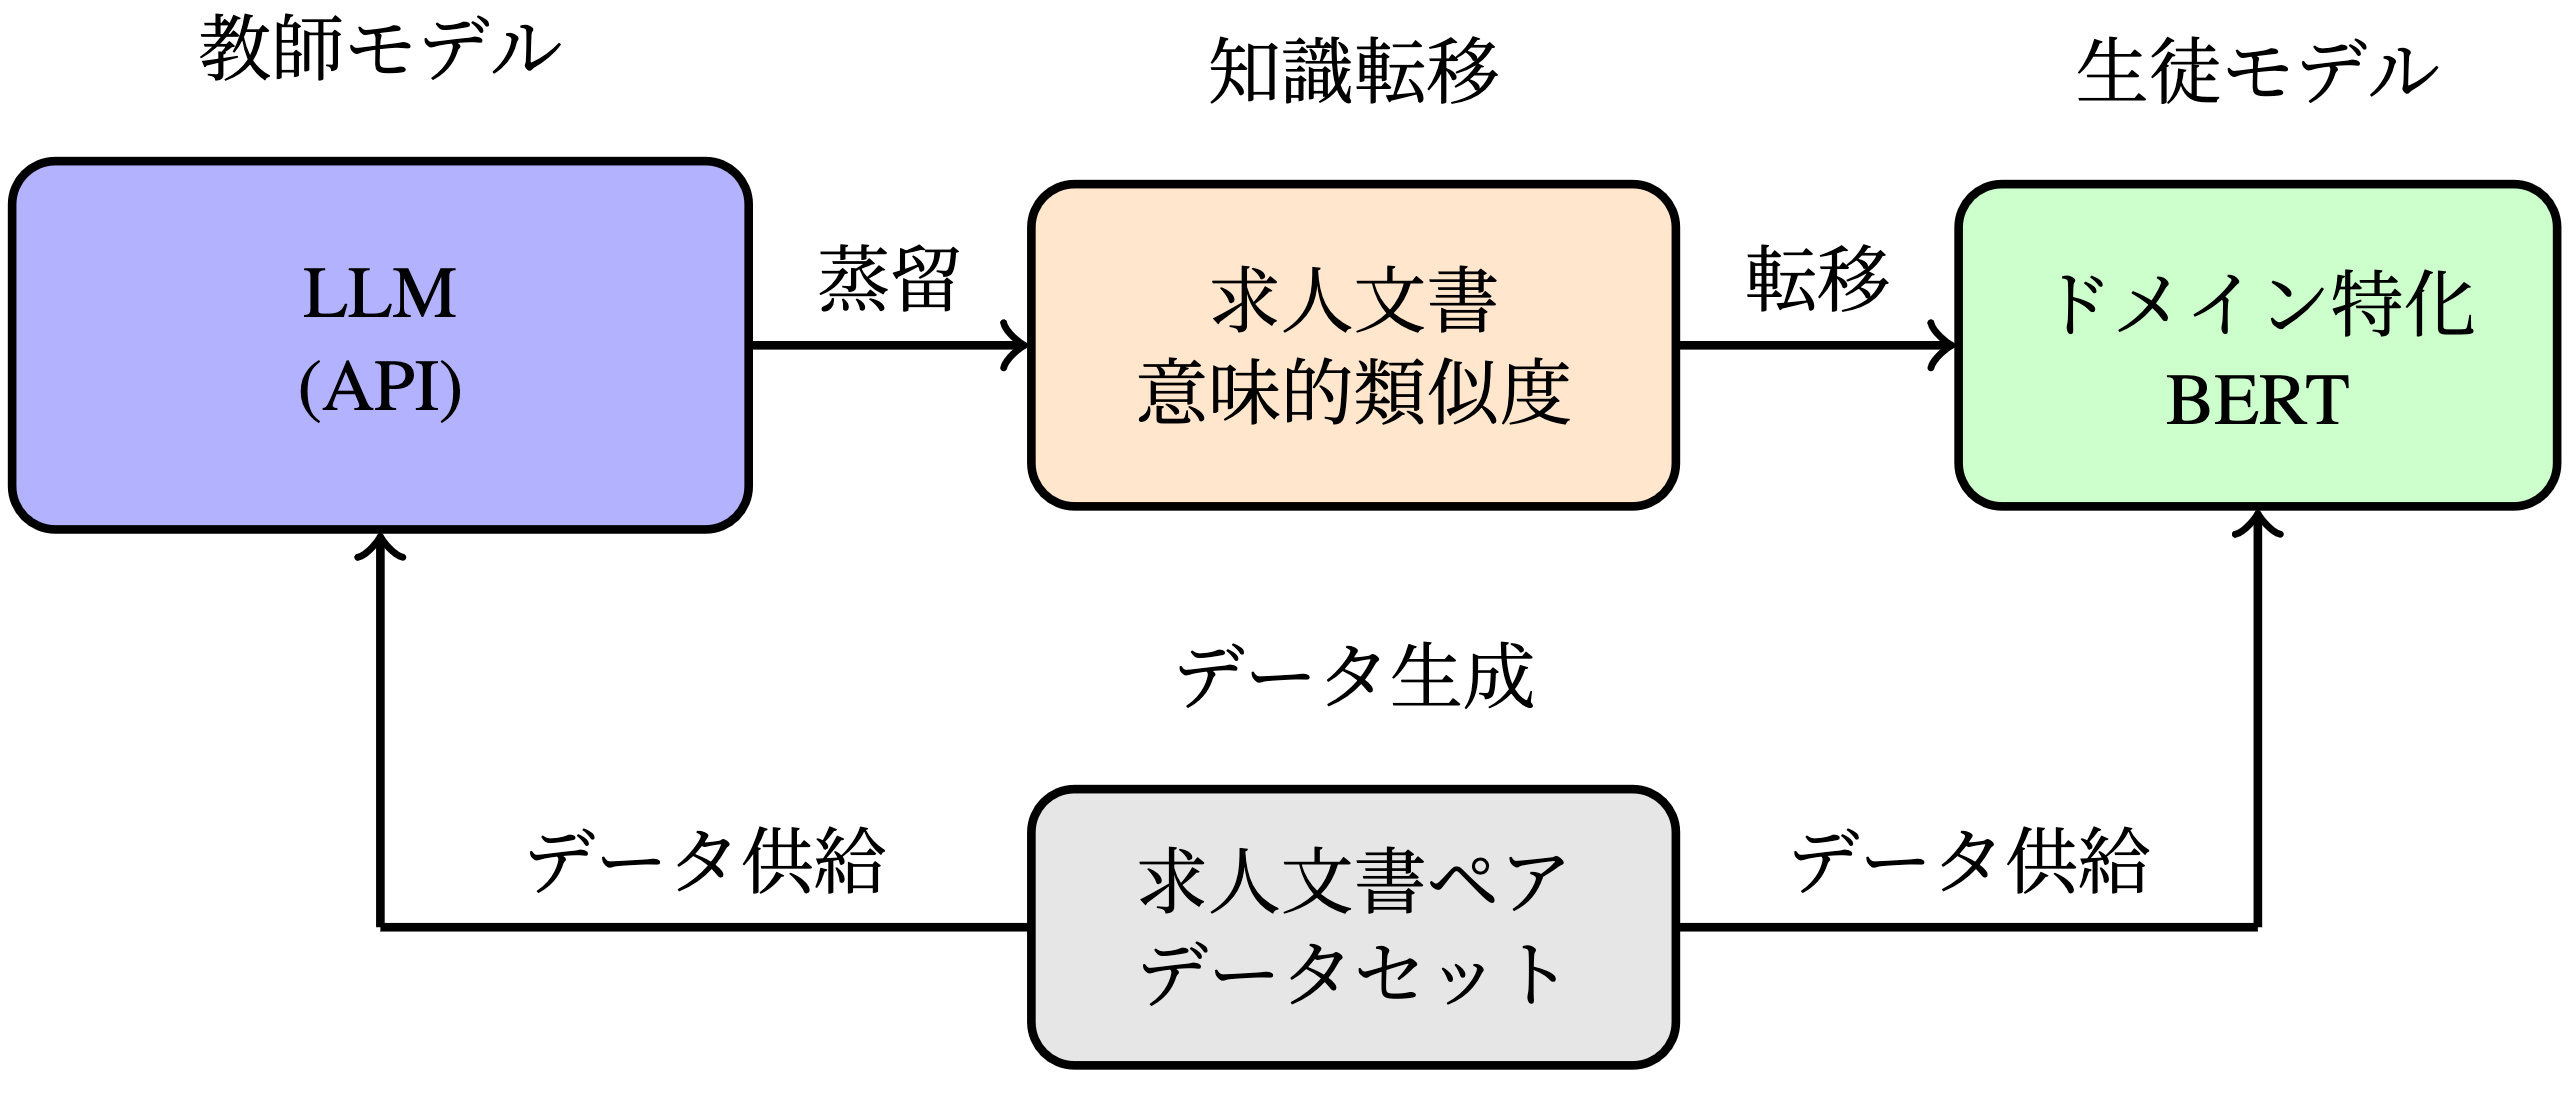
- STSデータセットの構築: 求人文書のテキストペアを戦略的にサンプリング
- LLMによるSTSスコアの自動生成: GPT-4o mini APIで意味的類似度スコアを付与
- BERTモデルのファインチューニング: 生成されたデータで軽量BERTを学習
次節より、各ステップの詳細を説明します。
Step 1: STSデータセットの構築
STS(Semantic Textual Similarity)とは、2つのテキストの意味的な類似度を数値で表すスコアです。意味的に近い文書は近く、異なる文書は遠く配置される埋め込み空間を学習するために、幅広い類似度スコアを持つペアデータが必要になります。
サンプリング戦略
ランダムにペアを生成すると、高類似度のペアが極端に少なくなるという問題があります。そこで以下の2段階のサンプリング戦略を採用しました。
-
25%:完全ランダムサンプリング
全求人文書から無作為にペアを生成しました。低類似度ペアを確保し、モデルの識別能力を向上させます。 -
75%:類似度優先サンプリング
同一の求職者が返信した複数の求人文書をペアとして組み合わせました。業務内容やスキル要件が類似する高類似度ペアを意図的に確保するための戦略です。
この2段階戦略により、スコアの分布が全域に広がる、バランスの取れたデータセットを構築できました。最終的に80,000組の求人文書ペアを生成し、train/validation/testを70%/15%/15%で分割しました。
Step 2: LLMによる意味的類似度スコアの自動生成
80,000組のペアすべてを人手でスコアリングすることは現実的ではありません。そこで、OpenAI APIを用いてSTSスコアを自動生成しました。
モデルの選定
精度・コスト・速度を総合的に考慮し、GPT-4o miniを採用しました。
プロンプト設計
以下の3つの評価軸を設定し、1.0〜5.0の連続値スコアで求人文書ペアを評価するプロンプトを設計しました。
- 職務内容
- 必要スキル
- 業務範囲
スコアは[[4.3]]のような構造化された形式のみで出力させることで、後続処理でのパースを容易にしています。
実際に使用したプロンプトを以下に示します。
あなたは、求人文書同士の意味的類似度(STS: Semantic Textual Similarity)を、職務内容・必要スキル・業務範囲に着目して評価するアシスタントです。
以下の2つの求人文書について、「職務内容」「必要スキル」「業務範囲」の観点から意味的な類似度を評価してください。
1.0〜5.0のスコア(小数点第1位まで)で、以下の評価基準に従って判断してください。
【評価基準】
- 1.0〜2.0: 類似性がほとんどない(業種や業務内容が大きく異なる)。
- 2.0〜3.0: 一部に共通するスキルや業務が見られるが、全体としては別の職種に相当する。
- 3.0〜4.0: 主な業務内容やスキルに明確な重なりがある。中程度の類似性。
- 4.0〜5.0: 表現の違いを除けば、職務内容・スキル・業務範囲はほぼ同じ。高い類似性。
【出力形式】
スコアのみを、
[[rating]]の形式で出力してください(例:[[4.3]])。スコア以外のコメントや説明は出力しないでください。
[求人文書1]
[求人文書2]以上を踏まえて、2つの求人文書の意味的な類似度は:
倫理的配慮およびバイアス対策
データの収集にあたっては、プライバシーポリシーに基づき、ユーザーの同意を得た上で公開されている求人文書のみを使用しました。また、OpenAI APIの利用にあたっては、データがモデルの訓練に使用されない設定とし、プライバシーとセキュリティに配慮しています。
LLMへの入力には、年齢・性別・学歴などの個人属性情報を一切含めず、テキスト内容のみに基づいた評価を行うことで、バイアスの増幅を防いでいます。また、推薦結果にバイアスが生じることを防ぐため、求人と候補者間のスカウト送信や返信、応募などの行動データは、モデルが学習する特徴量としては使用しない設計としました。
教師モデルとしたOpenAI APIは、正規の商用契約の範囲内で利用しました。生成したのは求人文書ペアの意味的類似度スコア(数値)のみであり、LLMの汎用的な言語能力の複製を目的としたものではありません。また、構築したモデルはビズリーチ社内での利用に限っており、外部には提供していません。
品質検証
LLMによるスコアの信頼性を確認するため、人材業界のアノテータ3名が独立にスコアリングした結果との比較を実施しました。スコア範囲(1.0〜2.0、2.0〜3.0、3.0〜4.0、4.0〜5.0)の4区間から各5件、計20件を抽出して評価した結果、以下の精度が得られました。
- Pearson相関係数: 0.932(人間判断との線形一致性が極めて高い)
- MAE(平均絶対誤差): 0.387(1.0〜5.0のスケールを考慮すると許容範囲内)
この結果から、LLMによるSTSスコアは教師データとして十分な信頼性を持つと判断しました。
Step 3: BERTモデルのファインチューニング
モデル構成
本研究では、社内の大規模テキストデータとWikipedia日本語コーパスを組み合わせ、Masked Language Modeling(MLM)で事前学習した独自の軽量BERTモデルを使用しています。主なスペックは以下の通りです。
- 最大入力長: 2048 tokens(長文求人文書に対応)
- モデルサイズ: 12M / 30M / 45Mの3種類(利用環境に応じて選択可能)
- トークナイザ: SudachiPy
- フレームワーク: Sentence Transformers
モデルを利用するサービスごとにレイテンシやメモリの要件が異なるため、3つのサイズを展開することで柔軟な適用を可能にしています。
ファインチューニング
Step 2で生成したデータセット(テキストペアとSTSスコア)を用いて、Sentence-BERT方式でファインチューニングを実施しました。
元のスコアは1.0〜5.0の連続値で付与されているため、コサイン類似度学習に適した0〜1の範囲に正規化しました。損失関数にはSentence-BERTで広く採用されているCosineSimilarityLossを使用し、テキストペア間のコサイン類似度を正解スコアに近づけるように最適化しました。
実験および結果
評価タスクと比較モデル
提案モデルを以下の2つのタスクで評価しました。
- STSタスク: 教師としたLLMのスコアをモデルがどの程度再現できているかをSpearman順位相関係数で評価
- 推薦タスク: 過去のスカウト送信履歴を正解ラベルとして、ローカル環境で算出した求人票と求職者レジュメのコサイン類似度ランキングをHit@Kで評価
※ここでの「推薦」は、企業に候補者の情報を提示することを指しており、ビズリーチが直接人材を紹介するものではありません。
比較対象として、日本語特化のOSSモデル(ruri-small、GLuCoSE-base-ja-v2)と、商用APIのOpenAI Embedding API(text-embedding-3-large)を用いました。
結果
スケールが異なる2つのタスクの指標を0〜100に正規化し、その平均を総合スコア(Avg.)として算出した結果を以下に示します。
| モデル | Emb. Size | STSタスク | 推薦タスク | 総合Avg. |
|---|---|---|---|---|
| BERT-45M-job-sts(提案) | 576 | 91.66 | 46.09 | 68.88 |
| OpenAI-Emb3-Large-3072(商用API) | 3072 | 85.70 | 51.46 | 68.58 |
| BERT-30M-job-sts(提案) | 512 | 91.67 | 44.24 | 67.95 |
| OpenAI-Emb3-Large-512(商用API) | 512 | 84.38 | 49.04 | 66.71 |
| BERT-12M-job-sts(提案) | 256 | 90.41 | 40.03 | 65.22 |
| OpenAI-Emb3-Large-256(商用API) | 256 | 81.74 | 45.47 | 63.60 |
| GLuCoSE-base-ja-v2-133M(汎用OSS) | 768 | 61.38 | 26.48 | 43.93 |
| ruri-small-68M(汎用OSS) | 768 | 71.26 | 13.81 | 42.54 |
考察
総合スコアでの優位性: 提案モデル(BERT-45M)が総合スコア68.88で最高値を達成し、OpenAI-Emb3-Large-3072(68.58)をわずかに上回りました。
STSタスクでの圧倒的精度: STSタスクでは提案モデルが91点台を記録し、OpenAIモデルと比較して約+6pt、汎用OSSモデルと比較して+20pt以上の大幅な向上が見られました。LLM知識蒸留により、求人文書の意味的類似度を高精度に捉えた埋め込み表現が獲得できたことを示しています。
推薦タスクでのOpenAI優位: 一方、推薦タスクではOpenAI-Emb3-Large-3072(51.46)が最高性能を示しました。OpenAI Embedding APIは多様なドメインで訓練されており、求人と候補者(レジュメ)間の潜在的な適合性を捉える汎化能力に優れていると考えられます。
軽量モデルの実用性: 最小の12Mモデルでも総合スコア65.22を達成しており、リソース制約のある環境でも十分な実用性を確保できています。
言語処理学会でいただいたフィードバック
本記事の内容はNLP2026のポスターセッション(C7-6)で発表し、様々なご意見・ご質問をいただきました。発表では、プロンプト設計や損失関数の選択といったR&Dで採用した手法に関する質問だけでなく、プロダクト実装やKPI改善のためのプロセスに関する質問もいただきました。
こうしたプロセスに関する質問への回答として特に関心を集めたのが、社内データセット上での比較実験にもとづくプロダクトへの導入判断の仕組みです。私たちは社内評価用のベンチマーク「ビズリーチベンチマーク」を構築しました。これは、意味的類似度・推薦タスクなど複数のタスクにおいて、異なるモデルと学習手法を横断的に比較・評価する仕組みです。このベンチマーク結果を根拠とすることで、最適なモデルと学習手法の選定、そしてプロダクトへの導入判断に十分な説得力を持たせることができました。
このような導入判断の話も含め、R&Dの成果をプロダクトにつなげていくための進め方について、同様の課題を持つ多くの参加者から高い評価をいただきました。
まとめ
本記事では、LLMを教師とした知識蒸留により、人材領域に特化した軽量BERT埋め込みモデルを構築する手法を紹介しました。
提案手法の主な成果は以下の3点です。
- 商用API同等以上の性能: 提案モデル(45M・576次元)が、OpenAI Embedding API(3072次元)を総合スコアで上回りました
- STSタスクでの圧倒的精度: 求人文書の意味的類似度理解において、OSSモデルを大幅に超える精度を実現しました
- 実運用でのメリット: ローカル推論によるセキュリティ確保、APIコストの削減、軽量モデルによる高速処理を同時に実現しました
本研究はNLP2026にて発表しており、予稿はこちらからご参照いただけます。
人材領域特化のLLM教師付き長文BERT埋め込みモデルの構築(NLP2026 C7-6)
ビズリーチでは、新しい仲間を募集しています。
お客様にとって価値あるモノをつくり、働く環境の変革に挑戦する仲間を募集しています。
募集中のポジションやプロダクト組織の詳細は、ぜひキャリア採用サイトをご覧ください。